Diagnóstico Inicial
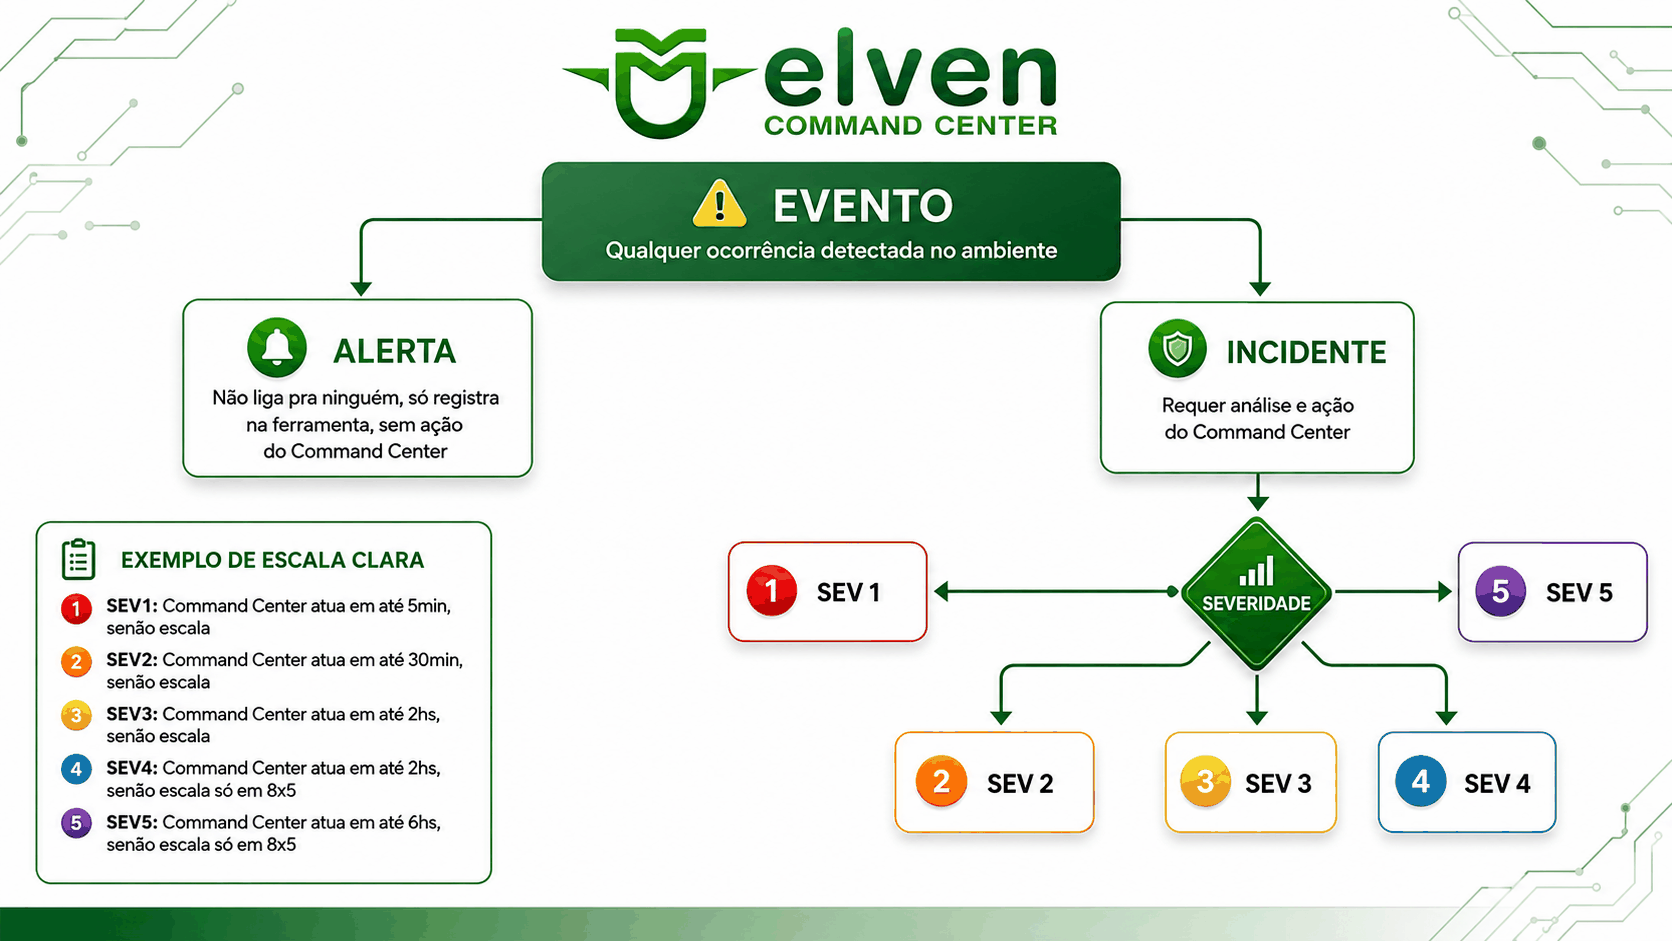
Os eventos que chegam ao Command Center são categorizados em dois tipos: Alertas e Incidentes. O Command Center está apto a receber os dois, e cada evento enviado para a equipe é contabilizado como um acionamento, a unidade usada para dimensionar a operação.
Alertas
- São sinais indicativos de problemas, gerados por sistemas de monitoramento ou observabilidade.
- Trazem indicadores de anomalias em geral, mas que não causam perda financeira ou de reputação.
Incidentes
- São sinais indicativos de problemas, gerados por sistemas de monitoramento ou observabilidade.
- Representam situações em que há perda financeira ou de reputação.
- São classificados por níveis de severidade, o que permite priorizar as ações da equipe do Command Center.
- Exigem intervenção da equipe do Command Center para aplicação de ações corretivas ou mitigadoras.
- Podem variar em gravidade — desde questões menores até problemas críticos que impactam significativamente a operação.
Em resumo
Alertas são avisos de situações que podem vir a gerar um incidente — por exemplo, CPU alta, memória alta, disco enchendo. Incidentes já são situações de indisponibilidade, perda financeira ou perda de reputação, com atuação imediata do Command Center 24x7 como suporte de primeiro nível para remediação.
Severidade e SLA de resposta
Todo incidente recebe um nível de severidade (SEV1 a SEV5), que define o tempo esperado de atuação do Command Center antes de escalar para o próximo nível:
- SEV1 — Command Center atua em até 5 minutos, senão escala.
- SEV2 — Command Center atua em até 30 minutos, senão escala.
- SEV3 — Command Center atua em até 2 horas, senão escala.
- SEV4 — Command Center atua em até 2 horas, senão escala (somente em horário comercial, 8x5).
- SEV5 — Command Center atua em até 6 horas, senão escala (somente em horário comercial, 8x5).
Exemplo de diagnóstico inicial
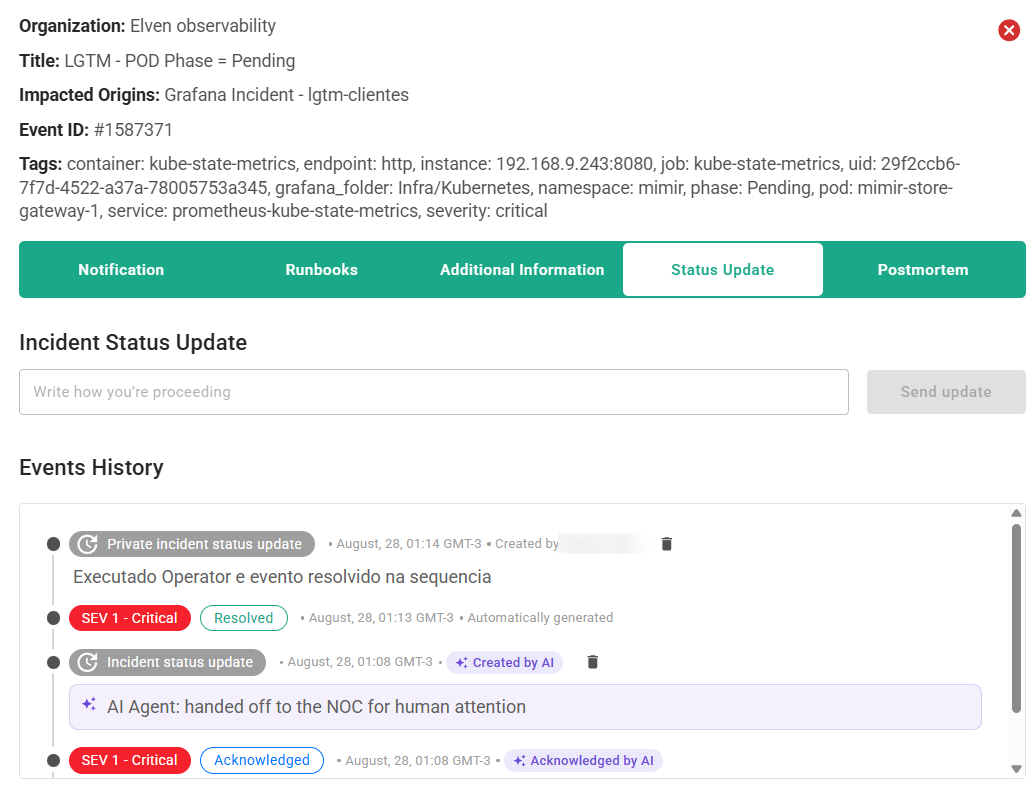
Na prática, o diagnóstico inicial de um evento já passa pelo AIOps antes de qualquer analista humano. No exemplo abaixo, um alerta de POD Pending é capturado e reconhecido automaticamente pela IA:
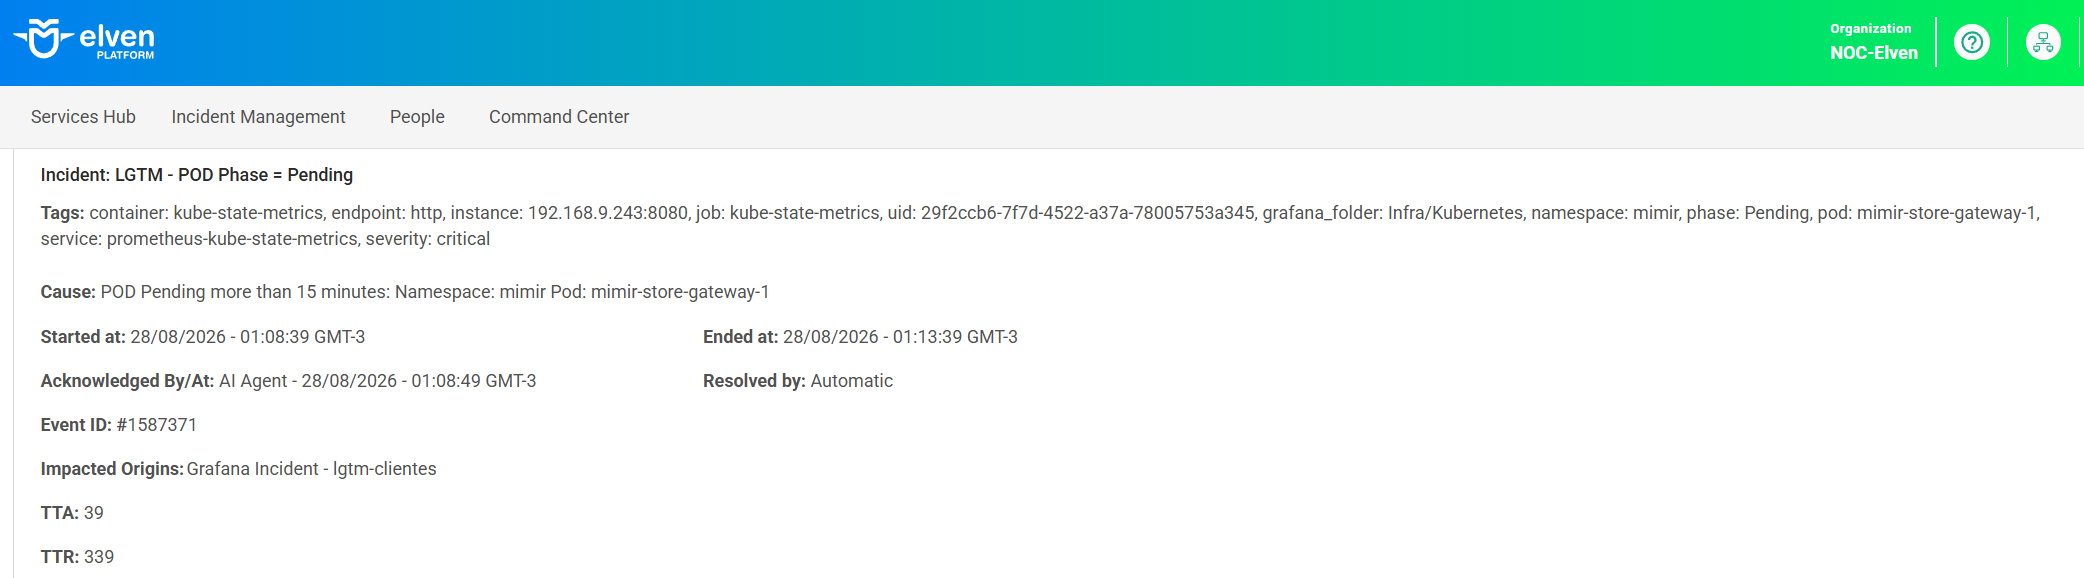
Como o evento não se resolveu sozinho — ou seja, não era um falso positivo — a IA encaminha o caso para o NOC (Command Center), registrando esse handoff no histórico do incidente. O analista então executa o runbook correspondente pelo Elven Operator, e o alerta é resolvido: